第 14 章 微积分与神经网络
学习目标
- 理解「训练模型 = 最小化损失函数」
- 掌握线性回归:解析法与梯度下降
- 理解逻辑回归与 sigmoid 函数
- 理解多层感知机与反向传播(链式法则)
- 用 PyTorch 训练一个小网络
- 回顾全书:微积分各部分在人工智能中的角色
14.1 训练模型,就是求最小值
前面 13 章学的所有工具,在这一章汇成一条主线:
损失函数(loss function) 是「参数 → 预测误差」的函数。训练模型,就是用梯度下降(第 13 章)沿着负梯度方向更新参数,让损失越来越小——而梯度由链式法则(第 5、11 章)自动算出。微积分不是神经网络的「附属品」,它就是训练引擎本身。
14.2 线性回归:最小二乘
最简单的模型:。给一批数据点 ,找最合适的 、。
均方误差(MSE)损失:
平方让正负误差都算数,除以 是取平均。求偏导(用第 11 章的链式法则,对括号内每一项):
推导第一式的关键一步:对 求导时, 的导数是 (链式法则:外层平方求导,乘内层对 的导数 ),再除以 、加和。
梯度下降更新:
import numpy as np

x = np.array([1.0, 2.0, 3.0, 4.0, 5.0])
y = np.array([2.9, 5.2, 6.8, 9.1, 11.3])

w, b = 0.0, 0.0
eta = 0.01
n = len(x)

for k in range(300):
    pred = w * x + b
    dw = -(2 / n) * np.sum(x * (y - pred))
    db = -(2 / n) * np.sum(y - pred)
    w -= eta * dw
    b -= eta * db
    if k % 60 == 0:
        loss = np.mean((y - pred) ** 2)
        print(f"步 {k:3d}: w = {w:.4f}  b = {b:.4f}  L = {loss:.4f}")

print(f"最终: w = {w:.4f}, b = {b:.4f}")步 0: w = 0.5064 b = 0.1412 L = 58.4380
步 60: w = 2.1279 b = 0.6410 L = 0.0326
步 120: w = 2.1172 b = 0.6795 L = 0.0299
步 180: w = 2.1086 b = 0.7108 L = 0.0282
步 240: w = 2.1015 b = 0.7364 L = 0.0270
最终: w = 2.0958, b = 0.7570真实规律是 附近(数据带噪声),梯度下降找回的 、,已很接近最优拟合直线。
14.3 逻辑回归:sigmoid 与分类
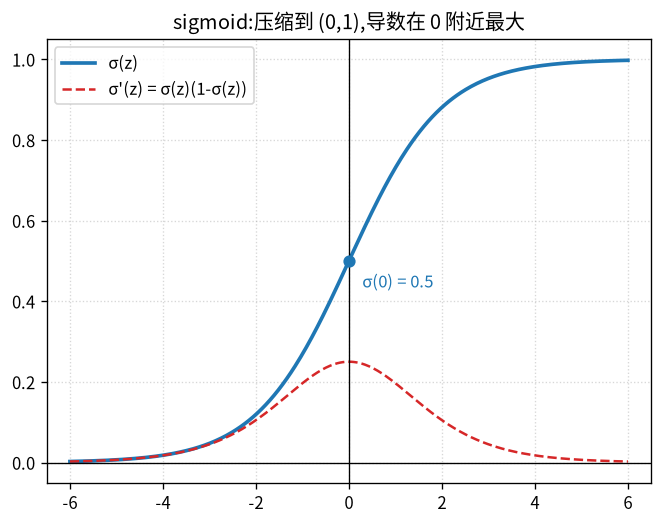
回归预测数值,分类判断类别(垃圾邮件/正常、猫/狗)。分类模型的输出要落在 之间,当作概率。sigmoid 函数把任意实数压缩到 :
import matplotlib.pyplot as plt
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

import numpy as np

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

z = np.linspace(-6, 6, 400)
fig, ax = plt.subplots(figsize=(6.5, 4.8))
ax.plot(z, sigmoid(z), color="tab:blue", linewidth=2.2, label="σ(z)")
ax.plot(z, sigmoid(z) * (1 - sigmoid(z)), color="tab:red", linestyle="--", label="σ'(z) = σ(z)(1-σ(z))")
ax.scatter([0], [0.5], color="tab:blue", s=40, zorder=4)
ax.annotate("σ(0) = 0.5", (0, 0.5), textcoords="offset points", xytext=(8, -16), color="tab:blue")
ax.set_xlim(-6.5, 6.5)
ax.set_ylim(-0.05, 1.05)
ax.axhline(0, color="black", linewidth=0.8)
ax.axvline(0, color="black", linewidth=0.8)
ax.grid(True, linestyle=":", alpha=0.5)
ax.legend()
ax.set_title("sigmoid:压缩到 (0,1),导数在 0 附近最大")
fig.savefig("book/public/figs/fig14-sigmoid.png", dpi=120, bbox_inches="tight")
plt.close(fig)
它的导数有个漂亮的性质(用商法则推导):
import numpy as np

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

for z in [-2, 0, 2]:
    s = sigmoid(z)
print(f"z = {z:3d} σ(z) = {s:.4f} σ'(z) = {s * (1 - s):.4f}")z = -2 σ(z) = 0.1192 σ'(z) = 0.1050
z = 0 σ(z) = 0.5000 σ'(z) = 0.2500
z = 2 σ(z) = 0.8808 σ'(z) = 0.1050导数在自己身上表达,梯度计算因此极其简洁——这是 sigmoid 在神经网络中流行的原因之一。
14.4 多层感知机:神经元与激活函数
线性模型只能拟合直线。真实数据大多是弯的,需要非线性。把多个「线性变换 + 非线性激活」叠起来,就是多层感知机(MLP)。
一个神经元做两件事:
先加权求和,再经过非线性激活函数 。多个神经元组成一层,层与层串联:
为什么必须非线性激活? 若全是线性运算,多层叠加仍是线性——不管叠多少层,都等价于一个线性模型,学不会弯曲的规律。激活函数(如 sigmoid、ReLU)给网络引入非线性,让它能逼近任意「足够平滑」的函数。
14.5 反向传播:链式法则的大规模应用
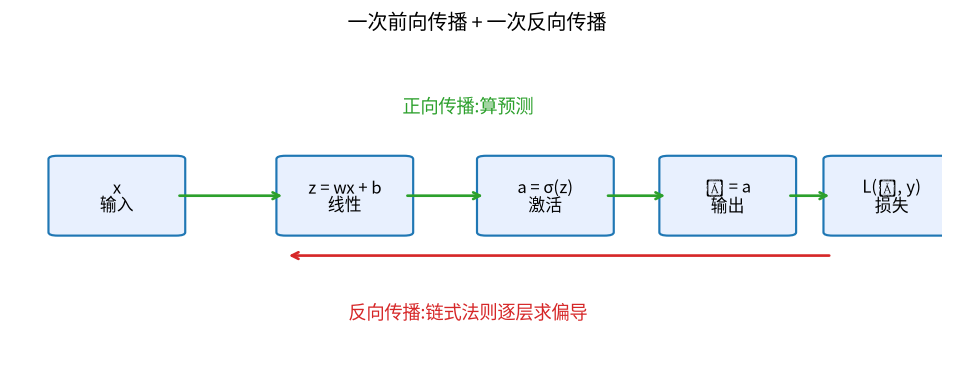
训练要算损失对每个参数的偏导。从输出到输入,每个参数都通过一条计算路径影响损失,这正是链式法则:
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

fig, ax = plt.subplots(figsize=(10, 3.6))

boxes = [
    ("x\n输入", 0.05),
    ("z = wx + b\n线性", 0.30),
    ("a = σ(z)\n激活", 0.52),
    ("ŷ = a\n输出", 0.72),
    ("L(ŷ, y)\n损失", 0.90),
]
for text, xc in boxes:
    ax.add_patch(FancyBboxPatch((xc, 0.42), 0.13, 0.22,
                 boxstyle="round,pad=0.01", facecolor="#e8f0fe",
                 edgecolor="tab:blue", linewidth=1.3))
    ax.text(xc + 0.065, 0.53, text, ha="center", va="center", fontsize=10)

for x1, x2 in [(0.18, 0.30), (0.43, 0.52), (0.65, 0.72), (0.85, 0.90)]:
    ax.annotate("", xy=(x2, 0.53), xytext=(x1, 0.53),
                arrowprops=dict(arrowstyle="->", color="tab:green", lw=1.6))

ax.annotate("正向传播:算预测", (0.50, 0.78), ha="center", color="tab:green", fontsize=11)
ax.annotate("反向传播:链式法则逐层求偏导", (0.50, 0.16), ha="center", color="tab:red", fontsize=11)
ax.annotate("", xy=(0.30, 0.35), xytext=(0.90, 0.35),
            arrowprops=dict(arrowstyle="->", color="tab:red", lw=1.6))

ax.set_xlim(0, 1.02)
ax.set_ylim(0, 1)
ax.axis("off")
ax.set_title("一次前向传播 + 一次反向传播")
fig.savefig("book/public/figs/fig14-backprop.png", dpi=120, bbox_inches="tight")
plt.close(fig)
过程分两步:
- 正向传播:从输入到输出,逐层算出预测 和损失 ;
- 反向传播:从损失出发,沿计算图反向,用链式法则把 逐层乘出来。
PyTorch 的 backward() 自动完成第二步,内部就是链式法则;第 13 章手写的梯度下降,现在换成完整网络:
import torch
import torch.nn as nn

torch.manual_seed(0)

# 数据:y = sin(x) + 噪声
x = torch.linspace(-3, 3, 200).reshape(-1, 1)
y = torch.sin(x) + 0.1 * torch.randn_like(x)

# 两层网络:线性 → 双曲正切激活 → 线性
model = nn.Sequential(
    nn.Linear(1, 16),
    nn.Tanh(),
    nn.Linear(16, 1),
)

loss_fn = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.05)

for epoch in range(1500):
    pred = model(x)
    loss = loss_fn(pred, y)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if epoch % 300 == 0:
print(f"epoch {epoch:4d}: loss = {loss.item():.4f}")epoch 0: loss = 0.2124
epoch 300: loss = 0.0216
epoch 600: loss = 0.0170
epoch 900: loss = 0.0150
epoch 1200: loss = 0.0136损失从 0.21 一路降到 0.014,网络学会了正弦曲线。画出来看拟合效果:
import matplotlib.pyplot as plt
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

import numpy as np
import torch
import torch.nn as nn

torch.manual_seed(0)
x_data = torch.linspace(-3, 3, 200).reshape(-1, 1)
y_data = torch.sin(x_data) + 0.1 * torch.randn_like(x_data)
model = nn.Sequential(nn.Linear(1, 16), nn.Tanh(), nn.Linear(16, 1))
optimizer = torch.optim.SGD(model.parameters(), lr=0.05)
loss_fn = nn.MSELoss()

for _ in range(1500):
    optimizer.zero_grad()
    loss = loss_fn(model(x_data), y_data)
    loss.backward()
    optimizer.step()

xs = np.linspace(-3, 3, 400).reshape(-1, 1)
with torch.no_grad():
    ys = model(torch.tensor(xs, dtype=torch.float32)).numpy()

fig, ax = plt.subplots(figsize=(7, 4.8))
ax.scatter(x_data.numpy(), y_data.numpy(), s=8, alpha=0.6, label="数据(带噪声)")
ax.plot(xs, ys, color="tab:red", linewidth=2.2, label="网络预测")
ax.plot(xs, np.sin(xs), color="tab:green", linestyle="--", label="真实 sin(x)")
ax.set_xlim(-3.3, 3.3)
ax.set_ylim(-1.5, 1.5)
ax.grid(True, linestyle=":", alpha=0.5)
ax.legend()
ax.set_title("1500 步训练后:网络拟合出正弦曲线")
fig.savefig("book/public/figs/fig14-fit.png", dpi=120, bbox_inches="tight")
plt.close(fig)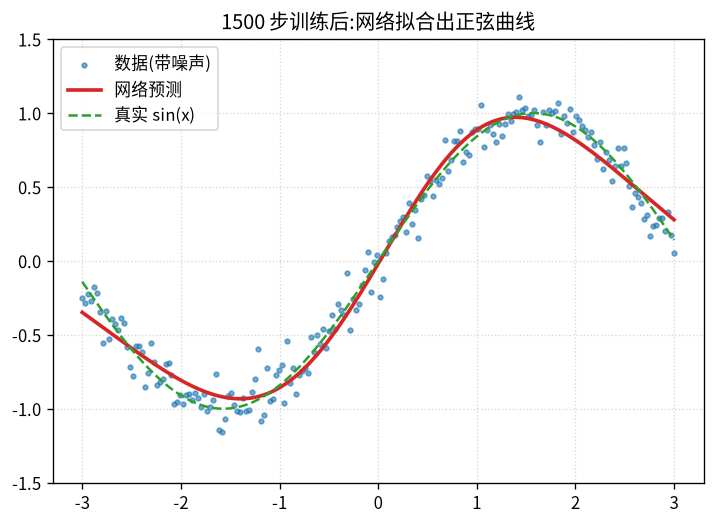
14.7 全书回顾:微积分与人工智能
把全书的知识点对应到神经网络训练中:
| 微积分概念 | 在人工智能中的作用 |
|---|---|
| 函数与图像(第 1 章) | 模型就是函数,数据是图像上的点 |
| 变化率与切线(第 2 章) | 参数变化一点点,损失变化多少 |
| 极限(第 3 章) | 收敛、无穷级数、学习率的极限行为 |
| 导数与链式法则(第 5~7 章) | 反向传播的全部数学 |
| 泰勒公式(第 7 章) | 优化算法的推导与近似分析 |
| 积分(第 8~10 章) | 期望、概率、贝叶斯、归一化 |
| 多元偏导与梯度(第 11 章) | 高维参数空间的优化方向 |
| 多元极值(第 12 章) | 损失函数的最小值问题 |
| 数值方法(第 13 章) | 离散化、数值稳定性、自动微分 |
一条主线贯穿始终:先理解变化的度量(导数),再理解积累的度量(积分),最后理解如何用它们找到最优解(最优化)。学到这里,你已经具备读懂神经网络训练代码背后的全部微积分基础。
常见错误
| 错误写法/理解 | 原因 |
|---|---|
| 线性回归损失用绝对值还要求导 | 绝对值在 0 处不可导;MSE 处处可导,方便梯度计算 |
| 认为多层线性网络也有非线性能力 | 线性复合仍是线性;非线性激活必不可少 |
| 把梯度下降步长当学习率以外的量 | 就是学习率,控制每一步参数更新幅度 |
忘记 zero_grad() | 梯度默认累加,不清零会叠加上一轮的梯度 |
| 认为网络能记住训练数据之外的一切 | 过拟合、泛化是另外的主题;本书只覆盖训练的微积分基础 |
章末练习
基础
- 写出线性回归损失对 、 的偏导公式,并解释链式法则在哪里出现。
- 用数值方法验证 处 。
- 用 PyTorch 训练 的线性回归(自己造数据),观察 、 是否收敛到 2 和 1。
提高
- 从 出发,用商法则完整推导 。
- 解释:为什么神经网络需要非线性激活函数?给出一个「两层线性 = 一层线性」的代数论证。
挑战
- 手动推导两层网络 对 的偏导(链式法则完整展开)。
- 把 14.6 的网络换一个激活函数(如 ReLU)或换学习率,比较收敛速度与最终损失,并解释差异。
章末自测
每题选择一个最佳答案。本书不附答案:完成后交由老师或 AI 老师批改讲解。
- 训练神经网络本质上是?
- A. 求损失函数的最小值
- B. 求损失函数的导数
- C. 解方程组
- D. 求定积分
- MSE 损失的形式是?
- A.
- B.
- C.
- D.
- sigmoid 函数的值域是?
- A.
- B.
- C.
- D.
- 等于?
- A.
- B.
- C.
- D.
- 为什么需要非线性激活?
- A. 让输出更小
- B. 多层线性等价于单层线性
- C. 为了好看
- D. 加快数据读取
- 反向传播的数学基础是?
- A. 积分
- B. 链式法则
- C. 勾股定理
- D. 洛必达法则
- 梯度下降中,学习率 控制?
- A. 每次更新的步长
- B. 训练数据数量
- C. 网络层数
- D. 损失函数
- 线性回归的梯度下降中, 包含?
- A.
- B.
- C.
- D.
- PyTorch 里
loss.backward()的作用是?- A. 更新参数
- B. 自动计算梯度(反向传播)
- C. 清零梯度
- D. 保存模型
- 神经元先加权求和,再经过?
- A. 积分
- B. 激活函数
- C. 求导
- D. 极限