第 13 章 数值微积分与最优化
学习目标
- 掌握数值微分(前向、中心差商)与误差来源
- 掌握数值积分(梯形法、辛普森法)
- 掌握牛顿法求根与求极值
- 掌握梯度下降算法
- 会用 PyTorch 自动微分实现梯度下降
- 理解学习率与收敛
13.1 为什么需要数值方法
微积分公式很美,但很多实际问题没有「解析解」:比如 没有初等原函数, 没有求根公式。计算机不会背公式,但它极擅长反复做加减乘除。数值方法就是把微积分的极限过程,翻译成计算机能执行的有穷步骤。
数值方法的核心思想贯穿全书:用「足够小」代替「无穷小」,用「足够多次」代替「无穷次」,误差随步长变小而收敛。
13.2 数值微分
导数定义是 。取一个小的、有限的 ,就得到前向差商:
更聪明的是中心差商:
用泰勒展开可以看出两者的误差:
前向差商的误差是 (减半误差也减半),中心差商是 (减半误差减到四分之一)——中间的 让误差项抵消了。所以中心差商精度高得多。
import numpy as np

def f(x):
    return np.sin(x)

x = 0.7
for h in [1e-2, 1e-4, 1e-6, 1e-8]:
    fwd = (f(x + h) - f(x)) / h
    ctr = (f(x + h) - f(x - h)) / (2 * h)
    print(f"h = {h:<6} 前向误差 = {abs(fwd - np.cos(x)):.3e}"
f" 中心误差 = {abs(ctr - np.cos(x)):.3e}")h = 0.01 前向误差 = 3.234e-03 中心误差 = 1.275e-05
h = 0.0001 前向误差 = 3.221e-05 中心误差 = 1.275e-09
h = 1e-06 前向误差 = 3.221e-07 中心误差 = 2.184e-11
h = 1e-08 前向误差 = 2.298e-09 中心误差 = 2.298e-09注意 时中心误差反而变大:计算机浮点数精度有限, 太小会引入舍入误差。实际使用中 取 左右是经验值。
13.3 数值积分
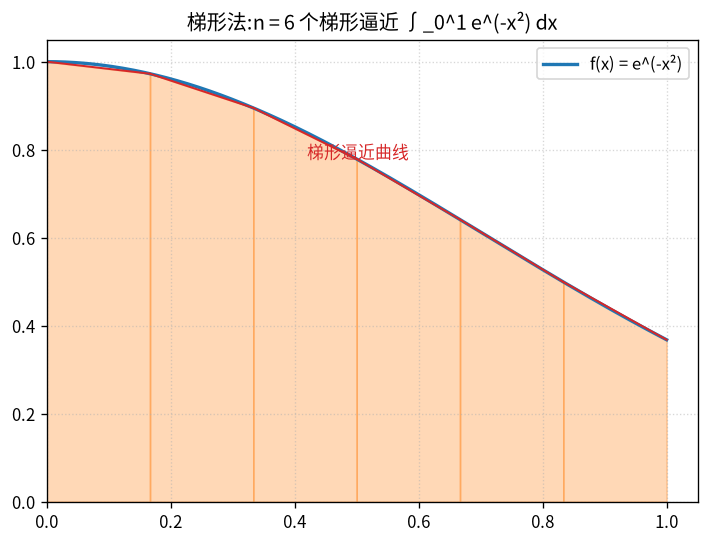
梯形法:把曲线下的区域切成梯形,每个梯形的面积 ,全部加起来:
辛普森法:在每两个小区间上用抛物线近似曲线,精度更高(误差 ):
import matplotlib.pyplot as plt
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

import numpy as np

def f(x):
    return np.exp(-x ** 2)

fig, ax = plt.subplots(figsize=(7, 5))
x = np.linspace(0, 1, 400)
ax.plot(x, f(x), color="tab:blue", linewidth=2, label="f(x) = e^(-x²)")

n = 6
edges = np.linspace(0, 1, n + 1)
for i in range(n):
    x0, x1 = edges[i], edges[i + 1]
    xs = [x0, x1]
    ys = [f(x0), f(x1)]
    ax.plot(xs, ys, color="tab:red", linewidth=1.2)
    ax.fill_between(xs, ys, color="tab:orange", alpha=0.3)

ax.annotate("梯形逼近曲线", (0.42, 0.78), color="tab:red")
ax.set_xlim(0, 1.05)
ax.set_ylim(0, 1.05)
ax.grid(True, linestyle=":", alpha=0.5)
ax.legend(loc="upper right")
ax.set_title("梯形法:n = 6 个梯形逼近 ∫_0^1 e^(-x²) dx")
fig.savefig("book/public/figs/fig13-trapezoid.png", dpi=120, bbox_inches="tight")
plt.close(fig)
算 这个没有初等原函数的积分:
import numpy as np

def f(x):
    return np.exp(-x ** 2)

a, b = 0.0, 1.0
for n in [10, 100, 1000]:
    x = np.linspace(a, b, n + 1)
    dx = (b - a) / n
    trap = (np.sum(f(x)) - (f(a) + f(b)) / 2) * dx
    simpson = dx / 3 * (f(a) + f(b)
                        + 4 * np.sum(f(x[1:-1:2]))
                        + 2 * np.sum(f(x[2:-2:2])))
print(f"n = {n:<5} 梯形 = {trap:.8f} 辛普森 = {simpson:.8f}")n = 10 梯形 = 0.74621080 辛普森 = 0.74682495
n = 100 梯形 = 0.74681800 辛普森 = 0.74682413
n = 1000 梯形 = 0.74682407 辛普森 = 0.74682413参考值 : 时辛普森已经准到 7 位小数,梯形法要 才追平——高阶方法的威力。
13.4 牛顿法求根
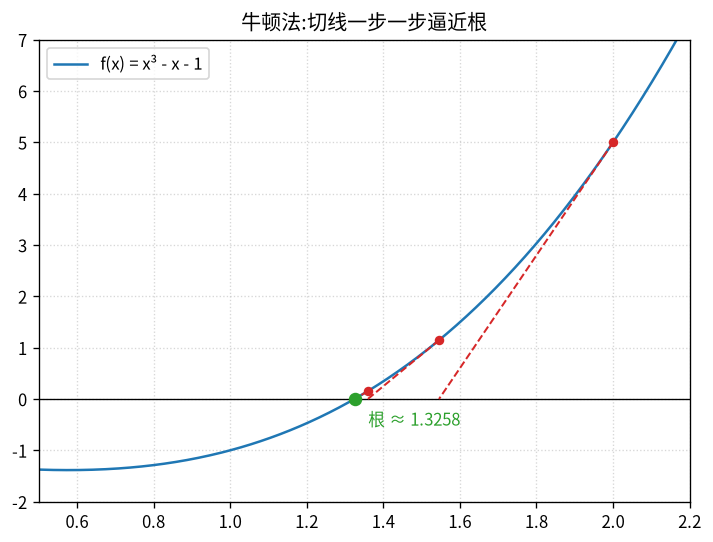
求 的根。牛顿法的想法:在当前的估计点 处画切线,切线与 轴的交点作为新的估计 。
切线方程:。令 ,解出 :
反复迭代,估计点快速逼近根。前提: 且初始点别太离谱。
import matplotlib.pyplot as plt
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

import numpy as np

def f(x):
    return x ** 3 - x - 1

def fp(x):
    return 3 * x ** 2 - 1

fig, ax = plt.subplots(figsize=(7, 5))
x = np.linspace(0.5, 2.2, 400)
ax.plot(x, f(x), color="tab:blue", label="f(x) = x³ - x - 1")
ax.axhline(0, color="black", linewidth=0.8)

x0 = 2.0
steps = [x0]
xn = x0
for _ in range(3):
    xn = xn - f(xn) / fp(xn)
    steps.append(xn)

for i in range(3):
    s = steps[i]
    xr = s - f(s) / fp(s)
    ax.plot([s, xr], [f(s), 0], color="tab:red", linestyle="--", linewidth=1.2)
    ax.scatter([s], [f(s)], color="tab:red", s=22, zorder=4)
ax.scatter([steps[-1]], [0], color="tab:green", s=50, zorder=5)
ax.annotate(f"根 ≈ {steps[-1]:.4f}", (steps[-1], 0),
            textcoords="offset points", xytext=(8, -16), color="tab:green")

ax.set_xlim(0.5, 2.2)
ax.set_ylim(-2, 7)
ax.grid(True, linestyle=":", alpha=0.5)
ax.legend()
ax.set_title("牛顿法:切线一步一步逼近根")
fig.savefig("book/public/figs/fig13-newton.png", dpi=120, bbox_inches="tight")
plt.close(fig)def f(x):
return x ** 3 - x - 1
def fp(x):
return 3 * x ** 2 - 1
x = 2.0
for k in range(6):
x = x - f(x) / fp(x)
print(f"第 {k + 1} 步: x = {x:.8f}")第 1 步: x = 1.54545455
第 2 步: x = 1.35961492
第 3 步: x = 1.32580135
第 4 步: x = 1.32471905
第 5 步: x = 1.32471796
第 6 步: x = 1.324717966 步就到 8 位小数,而第 4 章的二分法要 30 步才到类似精度——牛顿法收敛快(平方收敛),但每步要算导数。
13.5 牛顿法求极值
求极值 = 找 的根。把牛顿法应用到 上:
比如 ,极值在 :、。从 出发,一步就到位:
13.6 梯度下降:最优化的工作马
求极值还有另一条路,而且能自然推广到几十万个参数:梯度下降。
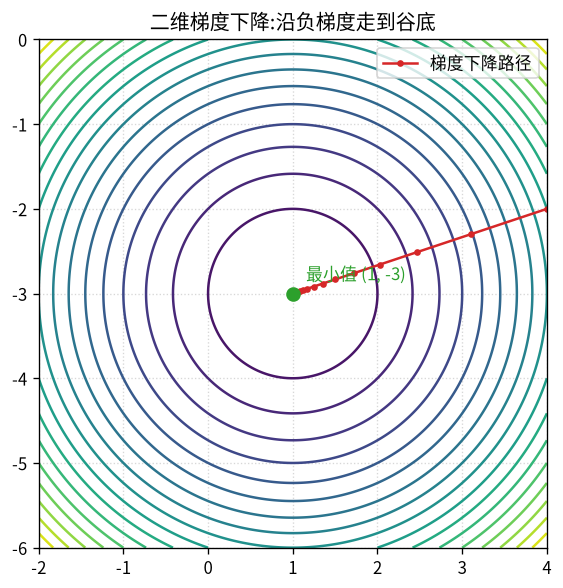
梯度下降(gradient descent):从初始点出发,每次沿负梯度方向迈一小步(因为梯度是上升最快方向,负梯度是下降最快方向):
其中 (读作 eta)叫学习率:每一步迈多大。
一维演示:,梯度 。从 出发,:
import numpy as np

def L(theta):
    return (theta - 3) ** 2

def dL(theta):
    return 2 * (theta - 3)

theta = 0.0
eta = 0.1
for k in range(20):
    theta = theta - eta * dL(theta)
    if k == 0 or k % 5 == 4:
print(f"第 {k + 1:2d} 步: θ = {theta:.6f} L = {L(theta):.3e}")第 1 步: θ = 0.600000 L = 5.760e+00
第 5 步: θ = 2.016960 L = 9.664e-01
第 10 步: θ = 2.677877 L = 1.038e-01
第 15 步: θ = 2.894447 L = 1.114e-02
第 20 步: θ = 2.965412 L = 1.196e-03每一步都朝 3 靠近,损失越来越小——这就是机器学习「训练」的本质:最小化损失函数。
import matplotlib.pyplot as plt
from matplotlib import font_manager
for f in font_manager.findSystemFonts():
    if any(k in f for k in ("NotoSansCJK", "NotoSansSC", "wqy", "SimHei", "msyh", "PingFang")):
        font_manager.fontManager.addfont(f)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Zen Hei", "SimHei", "Microsoft YaHei", "PingFang SC"]
plt.rcParams["axes.unicode_minus"] = False

import numpy as np

def L(t1, t2):
    return (t1 - 1) ** 2 + (t2 + 3) ** 2

def dL(t1, t2):
    return np.array([2 * (t1 - 1), 2 * (t2 + 3)])

x = np.linspace(-2, 4, 300)
y = np.linspace(-6, 0, 300)
X, Y = np.meshgrid(x, y)
Z = L(X, Y)

theta = np.array([4.0, -2.0])
eta = 0.15
path = [theta.copy()]
for _ in range(30):
    theta = theta - eta * dL(*theta)
    path.append(theta.copy())
path = np.array(path)

fig, ax = plt.subplots(figsize=(6.5, 5.5))
cs = ax.contour(X, Y, Z, levels=20, cmap="viridis")
ax.plot(path[:, 0], path[:, 1], color="tab:red", marker="o", markersize=3, label="梯度下降路径")
ax.scatter([1], [-3], color="tab:green", s=60, zorder=5)
ax.annotate("最小值 (1, -3)", (1, -3), textcoords="offset points", xytext=(8, 8), color="tab:green")
ax.set_xlim(-2, 4)
ax.set_ylim(-6, 0)
ax.set_aspect("equal")
ax.grid(True, linestyle=":", alpha=0.5)
ax.legend()
ax.set_title("二维梯度下降:沿负梯度走到谷底")
fig.savefig("book/public/figs/fig13-gd_path.png", dpi=120, bbox_inches="tight")
plt.close(fig)
13.7 用 PyTorch 自动微分实现梯度下降
PyTorch 的 autograd 自动算梯度(链式法则),optim 提供优化器。手写梯度下降循环:
import torch

theta = torch.tensor([4.0, -2.0], requires_grad=True)

def L(t):
    return (t[0] - 1) ** 2 + (t[1] + 3) ** 2

eta = 0.1
for k in range(60):
    L(theta).backward()
    with torch.no_grad():
        theta -= eta * theta.grad
    theta.grad.zero_()

print("迭代 60 次后 θ =", theta.detach().numpy())迭代 60 次后 θ = [ 1.0000045 -2.9999986]自动微分解决了「梯度怎么算」的问题,梯度下降解决「往哪走」的问题,两者组合就是第 14 章神经网络训练的核心引擎。
常见错误
| 错误写法/理解 | 原因 |
|---|---|
| 取得越来越小,误差一定越来越小 | 舍入误差会随 增大;存在最优 |
| 前向差商与中心差商精度一样 | 中心差商误差 ,远优于前向的 |
| 牛顿法在 处照常迭代 | 分母为零会除零;此时换初始点或用其他方法 |
| 学习率 取太大 | 步长过大可能越过谷底、来回震荡甚至发散 |
| 梯度下降方向用梯度本身 | 下降要走负梯度方向,因为梯度是上升方向 |
章末练习
基础
- 用中心差商()求 在 的数值导数,并与 比较。
- 用梯形法()算 ,并与 比较。
- 用牛顿法求 的正根(即 ),从 出发迭代 3 步。
提高
- 对 , 会怎样?手推前 3 步,解释为什么 会发散。
- 用 PyTorch 对 从 出发做 100 步梯度下降(),观察收敛到 的过程。
挑战
- 用泰勒展开推导中心差商的误差是 (写出 、 的展开并相减)。
- 比较二分法与牛顿法求 的收敛速度:各自迭代 5 步,比较误差。
章末自测
每题选择一个最佳答案。本书不附答案:完成后交由老师或 AI 老师批改讲解。
- 前向差商的误差阶是?
- A.
- B.
- C.
- D. 精确
- 中心差商公式是?
- A.
- B.
- C.
- D.
- 辛普森法的误差阶是?
- A.
- B.
- C.
- D. 精确
- 牛顿法迭代公式是?
- A.
- B.
- C.
- D.
- 梯度下降的更新公式是?
- A.
- B.
- C.
- D.
- 为什么走负梯度方向?
- A. 梯度是上升最快方向
- B. 负梯度是下降最快方向
- C. 梯度指向最小值
- D. 两者都对(A、B 都是理由)
- 学习率 太大可能导致?
- A. 收敛更快
- B. 震荡甚至发散
- C. 一定收敛
- D. 没有影响
- 数值微分时 取得过小会?
- A. 精度无限提高
- B. 舍入误差增大
- C. 没有影响
- D. 得到解析解
- 的数值是?
- A. 约 0.7468
- B. 约 1.0
- C. 约 0.5
- D. 约 2.0
- PyTorch 自动微分的原理是?
- A. 数值差商
- B. 链式法则
- C. 随机猜测
- D. 泰勒展开